Что нового
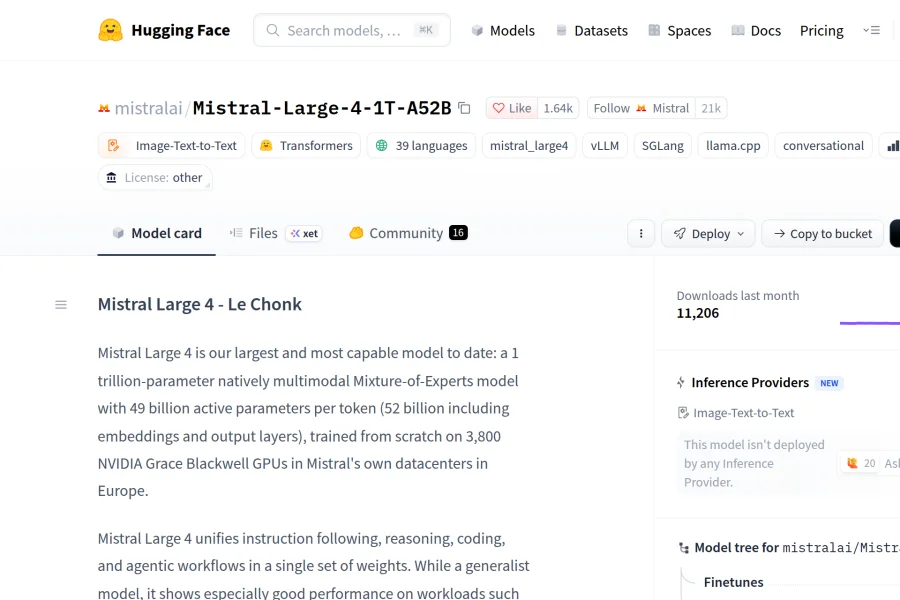
Модель описана как мультимодальная и многоязычная, собранная по схеме Mixture-of-Experts. На вход она принимает текст и изображения, на выходе только текст. Объём: около 1T параметров всего и 49B активных при контекстном окне 1M токенов.
Текстовый декодер состоит из 72 слоёв, скрытая размерность 6 144, число голов внимания 64. С первого дня заявлена поддержка transformers, vLLM и llama.cpp.
Что показали тесты
На тесте Artificial Analysis Cyber Index модель просят воспроизвести реальную уязвимость в открытом ПО, а затем закрыть её. Mistral Large 4 набирает там 82%. Компания отмечает, что ряд закрытых фронтирных моделей получает на этом же тесте около нуля, потому что отказывается браться за работу.
На Cybench модель решает 93% набора из 40 задач, взятых из соревнований по безопасности. На бенчмарке Lakera B3 заявлено 93,3% устойчивости к атакам. На индексе Artificial Analysis Intelligence по состоянию на 29 октября 2026 года модель занимает пятое место среди открытых.
Доступ, лицензия и ограничения
Веса опубликованы в коллекции Mistral Large 4 на Hugging Face. GGUF-версии сделали Unsloth и команда llama.cpp. Лицензия Mistral Ecosystem Open-Weight License описана как производная от MIT с ограничениями для тех, кто предлагает модель как сервис.
Рецепт Inference Endpoints рассчитан на 8 x NVIDIA H200: до 131K токенов контекста и до 16 запросов одновременно. Чекпоинт NVFP4 занимает меньше памяти, но требует GPU NVIDIA Blackwell. Reasoning отключить нельзя: параметр reasoning_effort: none всё равно даст высокий уровень. 2-битные кванты запускаются на одном компьютере Apple Silicon с 512 ГБ объединённой памяти, остальные варианты требуют распределённого инференса. Цены компания не называла.
Что это значит для авторов и селлеров
Открытые веса и поддержка распространённых инструментов могут пригодиться тем, кто хочет держать пайплайн генерации у себя. Работа с изображениями на входе и большое контекстное окно могут пригодиться для разбора референсов и длинных технических заданий.
Требования к железу стоит проверить заранее: часть вариантов рассчитана на несколько GPU и отдельные линейки ускорителей. Если модель планируется отдавать как сервис, имеет смысл заранее прочитать условия лицензии.
Как сделан текст: его подготовил ИИ по материалам источника, текст сверен с источником и проверен редактором. Иллюстрация создана ИИ для AISTETIKA и не является кадром из новости.